Wenn du KI-Crawler steuern willst, triffst du zwei getrennte Entscheidungen: Darf ein Anbieter deine Inhalte für das Training seiner KI-Modelle nutzen? Und soll deine Website in KI-Suchen und KI-Antworten verlinkt werden? Für das Training sperrst du in der robots.txt gezielt Trainings-Crawler wie GPTBot, ClaudeBot oder CCBot sowie die Steuer-Tokens Google-Extended und Applebot-Extended. Such-Crawler wie OAI-SearchBot, Claude-SearchBot oder PerplexityBot lässt du zu, wenn du in diesen Antworten sichtbar bleiben willst. Für Googles KI-Übersichten und den KI-Modus gibt es seit dem 31. August 2026 einen eigenen Schalter in der Search Console. Den Googlebot selbst sperrst du nie, sonst verschwindest du aus der normalen Google-Suche.
Welche KI-Crawler besuchen deine Website?
Die großen Anbieter trennen inzwischen sauber zwischen Crawlern für das Modelltraining, Crawlern für ihre Suchfunktion und Abrufen, die ein Nutzer im Chat auslöst. Für jede Gruppe gibt es eigene Namen (User-Agent-Tokens), die du in der robots.txt ansprechen kannst. Die folgende Tabelle fasst die Angaben aus den offiziellen Dokumentationen zusammen.
| Anbieter | Token | Zweck | Folge einer Sperre |
|---|---|---|---|
| OpenAI | GPTBot | Training der KI-Modelle | Inhalte sollen nicht ins Training einfließen, kein direkter Einfluss auf die ChatGPT-Suche |
| OpenAI | OAI-SearchBot | Suche in ChatGPT | Seite erscheint nicht in den Suchantworten von ChatGPT |
| OpenAI | ChatGPT-User | Abruf auf Wunsch eines Nutzers | robots.txt gilt laut OpenAI möglicherweise nicht |
| Anthropic | ClaudeBot | Training der KI-Modelle | Künftige Inhalte werden vom Training ausgeschlossen |
| Anthropic | Claude-SearchBot | Suchindex für Claude | Weniger Sichtbarkeit in Suchantworten von Claude |
| Anthropic | Claude-User | Abruf auf Wunsch eines Nutzers | Claude kann deine Seite bei Nutzerfragen nicht abrufen |
| Perplexity | PerplexityBot | Suchergebnisse in Perplexity, laut Anbieter kein Training | Weniger Sichtbarkeit in Perplexity |
| Google-Extended | Steuer-Token für Gemini-Training und Grounding, kein eigener Crawler | Kein Einfluss auf die Google-Suche | |
| Apple | Applebot-Extended | Steuer-Token für das Training von Apples Modellen, kein eigener Crawler | Kein Einfluss auf Spotlight, Siri und Safari |
| Common Crawl | CCBot | Offenes Web-Archiv, das laut Seokratie auch für KI-Training genutzt wird | CCBot soll deine Seite nicht mehr crawlen |
Die Angaben findest du in den Dokumentationen von OpenAI zu seinen Crawlern, von Anthropic zu ClaudeBot, Claude-SearchBot und Claude-User, von Perplexity zu PerplexityBot und Perplexity-User, bei Apple zu Applebot-Extended sowie bei Common Crawl zu CCBot. Eine gute deutschsprachige Einordnung der Bot-Typen liefert Seokratie im Beitrag zu technischem SEO und KI-Sichtbarkeit.
Warum solltest du Training und Suche getrennt entscheiden?
Viele Websites sperren pauschal alles, was nach KI klingt. Das schützt zwar vor dem Training, kostet aber Sichtbarkeit: Wer OAI-SearchBot sperrt, taucht laut OpenAI nicht mehr in den Suchantworten von ChatGPT auf. Umgekehrt hat eine Sperre von GPTBot keinen Einfluss darauf, ob deine Seiten in der ChatGPT-Suche erscheinen. OpenAI betont ausdrücklich, dass beide Einstellungen unabhängig voneinander sind.
Frag dich deshalb für jede Gruppe einzeln:
- Training: Ist es für dich in Ordnung, dass deine Texte in künftige KI-Modelle einfließen? Bei frei zugänglichen Ratgebern ist das oft vertretbar, bei exklusiven Daten, Studien oder kostenpflichtigen Inhalten eher nicht.
- Suche und Antworten: Willst du in KI-Antworten genannt und verlinkt werden? Für die meisten Unternehmen, Shops und Magazine lautet die Antwort Ja, weil hier neue Besucher entstehen.
- Nutzer-Abrufe: Darf ein Chatbot deine Seite öffnen, wenn jemand ausdrücklich danach fragt? Diese Abrufe lassen sich per robots.txt nur eingeschränkt steuern, weil OpenAI und Perplexity sie als vom Nutzer ausgelöst behandeln.
Wie steuerst du Googles KI-Funktionen?
Bei Google ist die Lage besonders, weil es keinen eigenen Such-Crawler für KI gibt. Der normale Googlebot crawlt für die Suche, und aus diesem Index speisen sich auch die KI-Übersichten. Google bietet dir deshalb zwei getrennte Werkzeuge.
Google-Extended für das Training
Google-Extended ist laut Googles Übersicht der Crawler ein eigenständiges Token ohne eigenen Crawler. Damit legst du fest, ob von Google gecrawlte Inhalte für das Training künftiger Gemini-Modelle und für Grounding in Gemini-Apps und Vertex AI genutzt werden dürfen. Die Aufnahme in die Google-Suche beeinflusst es laut Google nicht, und es ist kein Ranking-Signal. Weil Google-Extended nicht selbst crawlt, taucht es in deinen Server-Logs auch nicht auf.
Der Schalter für KI-Übersichten und KI-Modus
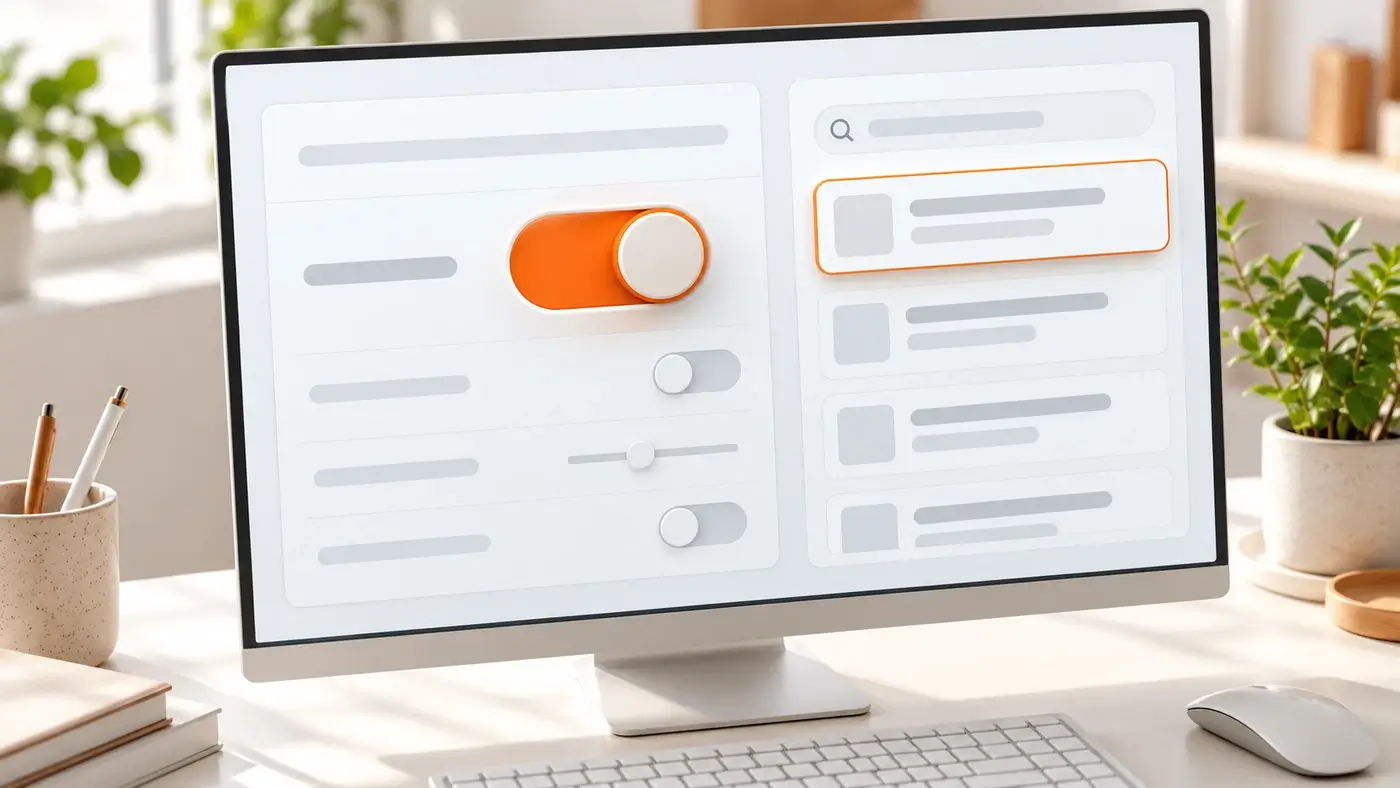
Seit dem 31. August 2026 steht allen Websites weltweit eine neue Einstellung zur Verfügung. Du findest sie in der Search Console unter Einstellungen → Generative KI in der Google Suche. Laut der Search-Console-Hilfe zur Steuerung generativer KI schließt du damit deine Inhalte von den Übersichten mit KI, dem KI-Modus und generativen KI-Funktionen in Discover aus. Deine Links erscheinen dort dann nicht mehr, und deine Inhalte dienen nicht zur Fundierung von KI-Antworten. Ausgeschlossene Inhalte verschwinden meist innerhalb von ein bis zwei Tagen.
Wichtig sind die Grenzen dieses Schalters. Er ist laut Google kein Ranking-Signal für die übrigen Suchergebnisse, er beeinflusst aber auch nicht das KI-Training. Wer beides will, kombiniert den Schalter mit Google-Extended. Google hat die Einführung im Blogbeitrag zu neuen Steuerungen für Website-Betreiber angekündigt. Der Ausschluss bedeutet auch: Du erhältst aus diesen Funktionen keine Impressionen und keine Klicks mehr. Ob sich das lohnt, prüfst du vorher im Leistungsbericht zu generativer KI. Wie du diesen Bericht liest, erklärt unser Beitrag zu Klickverlusten durch KI-Übersichten.
Was du bei Google nicht tun solltest
Sperre niemals den Googlebot, um KI-Übersichten zu vermeiden. Regeln für den Googlebot wirken laut Google auf die gesamte Suche einschließlich Discover, Bildern und News. Auch nosnippet ist kein gezieltes KI-Werkzeug, weil es zugleich deine normalen Snippets in den Suchergebnissen entfernt.
Schritt für Schritt: KI-Crawler in der robots.txt steuern
1. Ziel für jede Crawler-Gruppe festlegen
Schreib vor der ersten Änderung auf, welche Gruppe du zulassen und welche du sperren willst. Ein häufiges Ziel für Magazine und Shops lautet: Training sperren, KI-Suche zulassen, Google-Suche unverändert lassen. Wer exklusive Inhalte schützt, sperrt eventuell auch einzelne Verzeichnisse für Such-Crawler.
2. Aktuelle robots.txt prüfen
Ruf https://deine-domain.de/robots.txt im Browser auf. WordPress liefert eine virtuelle robots.txt aus, solange im Stammverzeichnis keine echte Datei liegt. Mit Yoast SEO legst du laut Yoast-Anleitung zur robots.txt unter Yoast SEO → Werkzeuge → Datei-Editor eine echte Datei an und bearbeitest sie dort. Fehlt der Menüpunkt, ist die Dateibearbeitung in WordPress deaktiviert. Dann bearbeitest du die Datei per FTP oder im Dateimanager deines Hosters.
3. Regelgruppen richtig anlegen
Hier passieren die meisten Fehler. Ein Crawler befolgt laut Googles Spezifikation der robots.txt nur eine einzige Gruppe, nämlich die mit dem spezifischsten passenden User-Agent. Eine eigene Gruppe für einen Bot und die allgemeine Gruppe mit * werden nicht kombiniert. Legst du also eine eigene Gruppe für OAI-SearchBot an, gelten deine allgemeinen Sperren etwa für /wp-admin/ für diesen Bot nicht mehr.
Am einfachsten ist es deshalb, nur die Bots einzeln zu nennen, die du sperren willst. Alle anderen Crawler, auch die Such-Crawler, folgen dann automatisch der allgemeinen Gruppe. Ein Beispiel:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
Disallow: /

Sitemap: https://deine-domain.de/sitemap_index.xml
Mehrere User-agent-Zeilen direkt untereinander bilden eine gemeinsame Gruppe. OAI-SearchBot, Claude-SearchBot, PerplexityBot und Googlebot sind in diesem Beispiel nicht genannt und dürfen deshalb alles crawlen, was die allgemeine Gruppe erlaubt. Prüfe nach dem Speichern, ob deine Sitemap-Adresse stimmt.
4. Datei testen und Wartezeiten einplanen
Öffne die Datei erneut im Browser und kontrolliere, ob die neue Fassung ausgeliefert wird. Bei aktivem Seiten-Cache musst du ihn eventuell leeren. Die Datei muss mit Status 200 antworten. Liefert sie einen 4xx-Fehler, behandelt Google das laut Spezifikation so, als gäbe es keine robots.txt. Bei 5xx-Fehlern stoppt Google das Crawling zunächst für zwölf Stunden. Plane außerdem Wartezeiten ein: Google speichert die robots.txt in der Regel bis zu 24 Stunden zwischen, OpenAI nennt für OAI-SearchBot ebenfalls etwa 24 Stunden.
5. Sperren auf Server und CDN prüfen
Die robots.txt ist nicht die einzige Stelle, an der Bots ausgesperrt werden. Firewalls, Sicherheits-Plugins und Content-Delivery-Netzwerke blockieren KI-Crawler teils ohne dein Wissen. Cloudflare hat seine frühere Einstellung „Block AI bots“ laut Cloudflare-Dokumentation zu KI-Bots durch Richtlinien für drei Kategorien ersetzt: Search, Agent und Training. Für neue Domains gelten seit dem 15. September 2026 Standardwerte, bei denen Training- und Agent-Bots auf Seiten mit Werbung blockiert werden, Such-Bots aber erlaubt bleiben. Bots, die sowohl Suche als auch Training bedienen, blockiert Cloudflare, sobald du Training sperrst. Kontrolliere diese Einstellungen, damit sie zu deiner robots.txt passen.
6. Logs auswerten und Bots verifizieren
Schau in die Zugriffsprotokolle deines Servers, welche Bots tatsächlich kommen und welche Statuscodes sie erhalten. Häufen sich 403-Antworten bei Such-Crawlern, die du eigentlich zulassen willst, greift irgendwo eine Sperre. Bedenke dabei, dass sich jeder Bot als Googlebot oder GPTBot ausgeben kann. Echte Google-Crawler erkennst du laut Googles Anleitung zur Verifizierung per Reverse-DNS-Abfrage (Hostname endet auf googlebot.com, google.com oder googleusercontent.com) oder über die veröffentlichten IP-Listen. Bei der Wahl eines Hosters mit guten Log-Zugängen hilft dir unser Hosting-Check für WordPress.
Welche Fehler solltest du vermeiden?
- Googlebot statt Google-Extended gesperrt: Damit verschwindet die Website aus der Google-Suche.
- Eigene Gruppe für Such-Bots ohne Grundregeln: Die allgemeinen Sperren gelten für diesen Bot dann nicht mehr.
- Nur per IP gesperrt: Anthropic weist darauf hin, dass eine IP-Sperre unzuverlässig ist, weil der Bot dann deine robots.txt nicht lesen kann.
- Subdomains vergessen: Jede Subdomain braucht eine eigene robots.txt, etwa für einen Shop unter shop.deine-domain.de.
- robots.txt als Zugriffsschutz verstanden: Die Datei ist eine Bitte an seriöse Crawler. Vertrauliche Inhalte schützt du per Passwort oder Anmeldung.
- Inhalte nur per JavaScript geladen: Laut Beobachtungen von Seokratie laden viele KI-Crawler nur das rohe HTML. Wichtige Inhalte sollten deshalb im ausgelieferten HTML stehen. Wie du die technische Basis allgemein prüfst, zeigt unser Leitfaden zu technischem SEO auf deiner Website.
Checkliste: KI-Crawler steuern
- Ziel je Gruppe festgelegt: Training, KI-Suche, Nutzer-Abrufe, Google-Suche
- Trainings-Crawler und Steuer-Tokens in einer gemeinsamen Gruppe gesperrt
- Such-Crawler nicht separat genannt oder mit vollständigen Grundregeln versehen
- Googlebot nicht gesperrt
- Entscheidung zum Search-Console-Schalter für KI-Übersichten bewusst getroffen
- robots.txt antwortet mit Status 200 und zeigt die neue Fassung
- Cache geleert und 24 Stunden Wartezeit eingeplant
- Firewall, Sicherheits-Plugin und CDN auf eigene Bot-Sperren geprüft
- Subdomains mit eigener robots.txt versorgt
- Server-Logs nach einigen Tagen auf 403-Antworten und gefälschte Bots geprüft
Häufige Fragen zu KI-Crawlern
Verliere ich Sichtbarkeit in ChatGPT, wenn ich GPTBot sperre?
Nein. Laut OpenAI entscheidet OAI-SearchBot über die Sichtbarkeit in den Suchantworten von ChatGPT. GPTBot betrifft nur das Training. Beide Einstellungen sind unabhängig voneinander.
Halten sich alle KI-Bots an die robots.txt?
Die großen Anbieter sagen zu, ihre automatischen Crawler über die robots.txt steuern zu lassen. Abrufe, die ein Nutzer im Chat auslöst, behandeln OpenAI und Perplexity anders: Hier gelten die Regeln laut Anbieter möglicherweise oder in der Regel nicht. Gegen Bots, die sich nicht an Regeln halten, helfen nur Sperren auf Server- oder CDN-Ebene.
Reicht Google-Extended, um aus den KI-Übersichten zu verschwinden?
Nein. Google-Extended steuert Training und Grounding für Gemini-Apps und Vertex AI, nicht die KI-Funktionen der Google-Suche. Dafür nutzt du den Schalter in der Search Console.
Brauche ich zusätzlich eine llms.txt?
Für die Steuerung von Crawlern nicht. Die llms.txt ist ein Vorschlag für eine Übersichtsdatei, deren Nutzung durch KI-Anbieter laut Seokratie nicht bestätigt ist. Verbindlich steuerst du Crawler weiterhin über die robots.txt.
