Technisches SEO sorgt dafür, dass Suchmaschinen deine wichtigen Seiten erreichen, verstehen und eindeutig zuordnen können. Prüfe zuerst, ob die richtige URL öffentlich erreichbar und für die Indexierung freigegeben ist. Danach kontrollierst du interne Links, doppelte Adressen und die Sitemap. Diese Reihenfolge hilft dir, konkrete Hindernisse zu beheben, bevor du dich in einzelnen Optimierungswerten verlierst.
Eine technisch saubere Website erhält dadurch keine automatische Platzierung. Sie schafft die Voraussetzung dafür, dass ihre Inhalte überhaupt sinnvoll verarbeitet werden können. Ob ein Beitrag eine Suchanfrage beantwortet, bleibt eine eigene redaktionelle Aufgabe.
Technisches SEO beginnt mit den richtigen Zielseiten
Lege zunächst fest, welche Seiten gefunden werden sollen. Bei einem kleinen Magazin können das die Startseite, gut gepflegte Kategorien und die veröffentlichten Artikel sein. Interne Suchergebnisse, unfertige Entwürfe oder Varianten derselben Adresse haben einen anderen Zweck. Eine Liste deiner gewünschten Zielseiten verhindert, dass du versehentlich jede vorhandene URL als wichtig behandelst.
Notiere für jede Zielseite die bevorzugte Adresse, ihren Zweck und den Weg dorthin. Ein Ratgeber sollte beispielsweise über seine Kategorie oder einen passenden anderen Beitrag erreichbar sein. Eine Seite, die du selbst nur über eine alte Nachricht findest, ist ein Anlass, die Navigation und Verlinkung zu prüfen.
Praktischer Start: Nimm einen veröffentlichten Artikel und gehe seinen Weg durch: Startseite, Kategorie, Artikel. Öffne ihn anschließend direkt über seine vollständige Adresse. Funktionieren beide Wege und führen sie zur gleichen Fassung?
Crawling, Indexierung und Suchergebnis sind drei Schritte
Google unterscheidet zwischen dem Abrufen einer Seite, der Verarbeitung für den Index und der Auswahl eines Ergebnisses für eine Suchanfrage. Diese Schritte hängen zusammen, sind aber nicht dasselbe. Eine abgerufene Seite muss nicht in den Index gelangen. Und eine indexierte Seite muss nicht bei deiner gewünschten Suchanfrage erscheinen. So beschreibt es die Google-Dokumentation zur Funktionsweise der Suche.
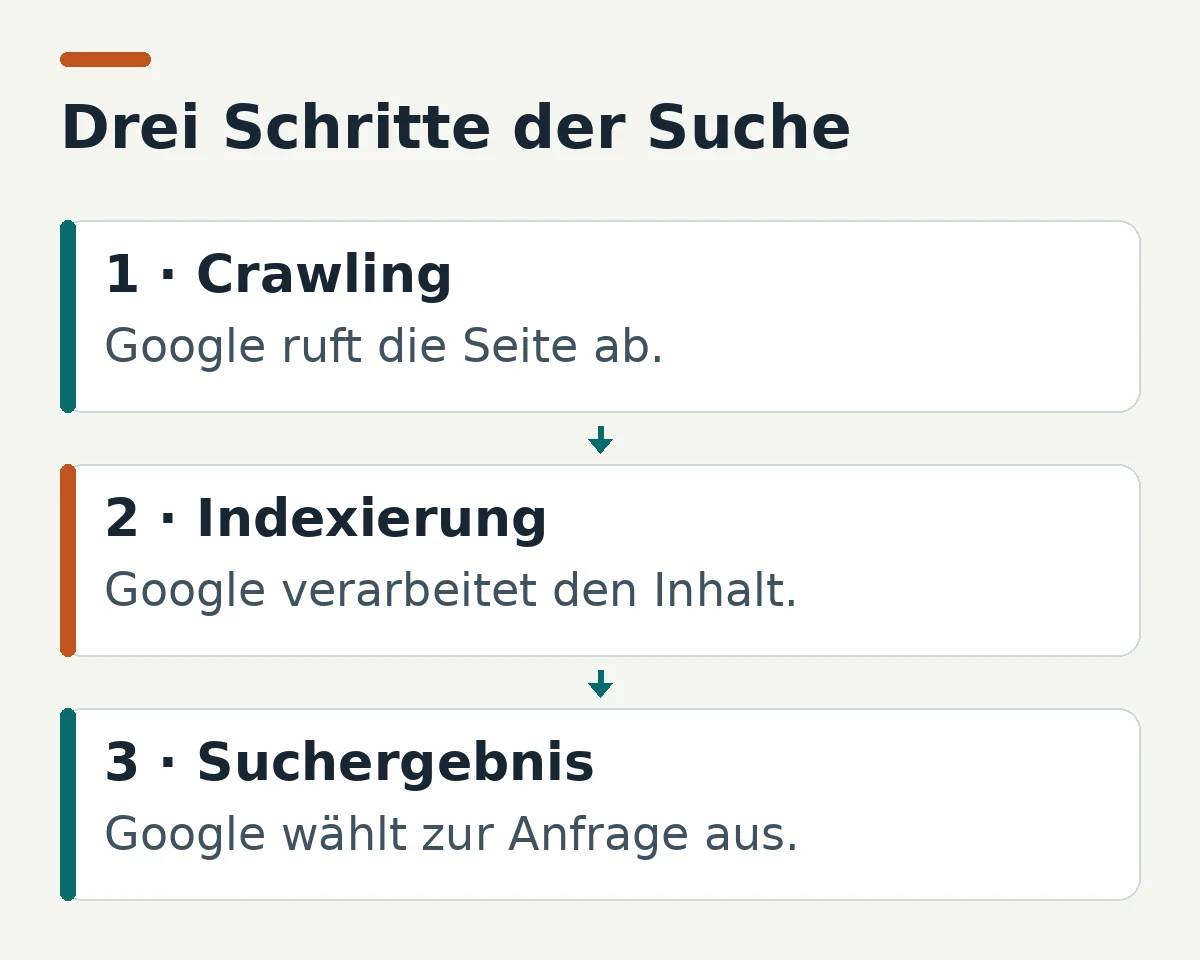
Diese Unterscheidung macht die Fehlersuche genauer. „Google findet meinen Artikel nicht“ kann bedeuten, dass die Adresse noch unbekannt ist, dass eine technische Anweisung die Indexierung verhindert oder dass ein bereits indexierter Text für die geprüfte Anfrage nicht ausgewählt wird.
Nutze in der Search Console die URL-Prüfung für die konkrete Adresse. Unterscheide dabei den gemeldeten Indexstand von einem aktuellen Live-Test. Ein erfolgreicher Live-Test zeigt nicht automatisch, dass Google die Seite schon aufgenommen hat. Dokumentiere, was das Werkzeug tatsächlich meldet, statt aus einer einzelnen grünen Anzeige eine vollständige Freigabe abzuleiten.
Erreichbarkeit und Weiterleitungen kontrollieren
Öffne eine Zielseite ohne WordPress-Anmeldung. So erkennst du beispielsweise, ob Besucher versehentlich eine Anmeldeseite, einen Wartungshinweis oder einen nicht verfügbaren Entwurf erhalten. Das Aussehen allein reicht allerdings nicht: Auch eine hübsch gestaltete Fehlerseite kann ein Fehler bleiben.
Kontrolliere zusätzlich den HTTP-Status, etwa im Netzwerkbereich der Browser-Entwicklerwerkzeuge. Eine regulär ausgelieferte Inhaltsseite sollte nicht unbeabsichtigt einen Fehlerstatus melden. Wenn du eine Adresse dauerhaft ersetzt hast, sollte der alte Link nachvollziehbar zur passenden neuen Seite führen. Mehrere unnötige Zwischenstationen erschweren die Kontrolle.
- Existierender Inhalt: Die gewünschte Seite wird direkt und vollständig ausgeliefert.
- Verschobener Inhalt: Die alte Adresse führt zur inhaltlich passenden neuen Adresse.
- Entfernter Inhalt: Eine verständliche Fehlerseite erklärt die Situation; eine beliebige Weiterleitung zur Startseite ersetzt keine passende Zuordnung.
Ändere funktionierende Artikeladressen deshalb nicht nur, weil eine andere Schreibweise etwas hübscher wirkt. Prüfe zuerst, welchen konkreten Vorteil die Änderung hätte und welche bisherigen Links betroffen wären.
Technisches SEO: robots.txt und noindex richtig unterscheiden
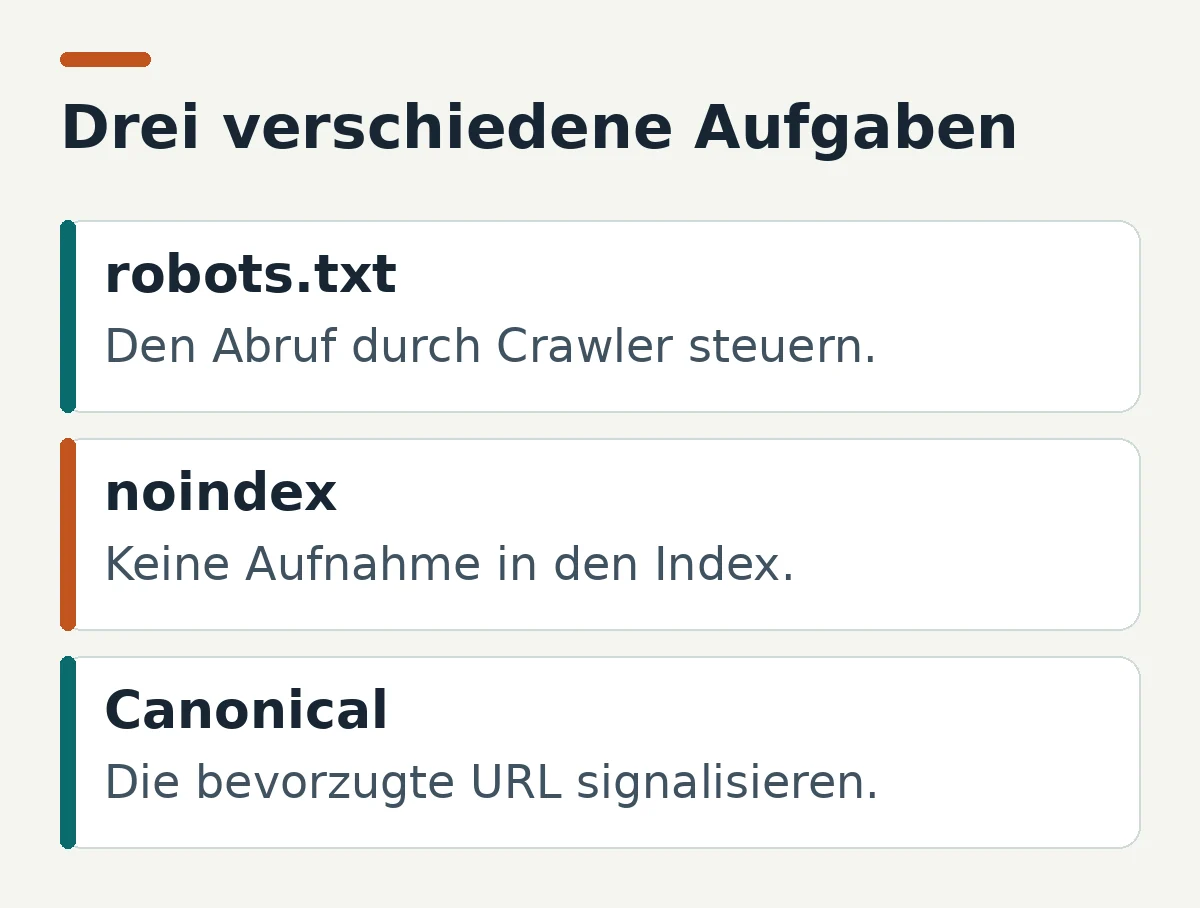
Die robots.txt-Datei regelt, welche Bereiche ein Crawler abrufen soll. Sie ist kein Passwortschutz. Außerdem kann Google eine gesperrte URL unter bestimmten Umständen trotzdem als Adresse kennen und anzeigen. Vertrauliche Informationen gehören daher hinter eine tatsächliche Zugangskontrolle. Das erläutert Google in der Einführung zu robots.txt.
noindex hat eine andere Aufgabe: Die Anweisung fordert, eine Seite nicht in den Index aufzunehmen. Damit Google sie auf der Seite oder im HTTP-Header erkennen kann, darf der Abruf nicht gleichzeitig durch robots.txt blockiert sein. Diese Voraussetzung ist in der Dokumentation zu noindex ausdrücklich beschrieben.
Prüfe bei einer unerwartet fehlenden Seite deshalb die tatsächlich ausgelieferte Fassung. Eine Einstellung im Backend ist ein Ausgangspunkt, aber noch kein Beleg dafür, was ein Besucher oder Crawler erhält. Gerade nach Änderungen sollte die Kontrolle die öffentliche Ausgabe einbeziehen.
Beispiel: Ein fertiger Ratgeber bleibt nach dem Wechsel aus einer Entwicklungsumgebung mit einer versehentlichen noindex-Anweisung online. Die richtige Maßnahme ist, diese konkrete Ursache zu korrigieren und die Ausgabe erneut zu prüfen. Mehr Text oder eine zweite Sitemap lösen dieses Problem nicht.
Eine bevorzugte Adresse pro Inhalt festlegen
Derselbe Inhalt kann über mehrere Adressen erreichbar werden, etwa durch Parameter oder Varianten mit und ohne abschließenden Schrägstrich. Ein Canonical-Verweis benennt eine bevorzugte Fassung. Google behandelt ihn als Signal und kann anhand weiterer Hinweise eine andere Adresse auswählen. Er ist daher keine Garantie und kein Ersatz für eine schlüssige Seitenstruktur.
Achte auf übereinstimmende Signale: Interne Links sollten zur bevorzugten Fassung führen, der Canonical-Verweis sollte dazu passen und die Sitemap sollte keine widersprüchliche Variante hervorheben. Google beschreibt diese Zusammenhänge in der Anleitung zur Zusammenführung doppelter URLs.
Bei einer kleinen Website lohnt sich eine überschaubare Stichprobe. Prüfe Startseite, Kategorie und zwei Artikel. Zeigt ein Beitrag versehentlich auf die Startseite als Canonical, ist das deutlich dringlicher als eine kosmetische Änderung an einer bereits verständlichen URL.
Sitemap und interne Links sinnvoll einsetzen
Eine Sitemap macht Suchmaschinen auf relevante Adressen aufmerksam. Sie garantiert weder den Abruf noch die Aufnahme in den Index. Halte sie deshalb sauber und überprüfe, ob die gewünschten veröffentlichten Seiten enthalten sind. Die Google-Übersicht zu Sitemaps ordnet ihren Zweck genauer ein.
Interne Links erfüllen zusätzlich eine Aufgabe für Leser. Ein hilfreicher Verweis führt an der passenden Stelle zu einer Vertiefung. Statt „hier klicken“ benennt der Linktext möglichst klar, was die Zielseite erklärt. Für Suchmaschinen ist ein normaler Link mit einer URL im href-Attribut der verlässliche Ausgangspunkt; siehe Googles Hinweise zu crawlbaren Links.
Verlinke zum Beispiel aus einem Abschnitt über Navigation auf den Leitfaden zur Tastaturbedienung deiner Website. Das bietet eine konkrete Vertiefung. Eine zufällige Sammlung weiterer Artikel am Absatzende hilft dagegen wenig, wenn der Zusammenhang unklar bleibt.
Fehler nach ihrer Wirkung priorisieren
Beginne mit Problemen, die wichtige Inhalte vollständig unzugänglich machen oder ihre gewünschte Indexierung verhindern. Danach folgen widersprüchliche Adressen und fehlende interne Wege. Ladezeit und Darstellung sind ebenfalls relevant; sie benötigen jedoch eine eigene Diagnose. Der Beitrag über eine schnellere WordPress-Website erklärt, wie du Bilder, Skripte und Caching getrennt untersuchst.
- Wichtige Zielseiten festhalten und öffentlich öffnen.
- Status, Zugang und ausgelieferte Indexierungsanweisungen prüfen.
- Bevorzugte Adressen und interne Links abgleichen.
- Sitemap auf die gewünschten veröffentlichten Seiten prüfen.
- Änderungen einzeln dokumentieren und die öffentliche Ausgabe erneut kontrollieren.
Notiere jeweils URL, Befund, Maßnahme und Prüfdatum. So kannst du später erkennen, ob ein Problem tatsächlich behoben wurde. Eine lange Liste allgemeiner Empfehlungen ist weniger hilfreich als drei sauber überprüfte Korrekturen an wichtigen Seiten.
Häufige Fragen zu technischem SEO
Wie schnell wird eine neue Seite indexiert?
Dafür lässt sich keine feste Frist versprechen. Prüfe Erreichbarkeit, Indexierungsanweisungen und interne Verlinkung. Die Search Console hilft dir, den bekannten Stand einzuordnen. Wiederholtes Einreichen ersetzt weder eine technische Korrektur noch einen eigenständigen, hilfreichen Inhalt.
Muss eine kleine Website ihr Crawling-Budget optimieren?
Starte bei einer überschaubaren Website mit den tatsächlich beobachteten Problemen. Wenn wenige wichtige Seiten fehlen, prüfe zuerst deren konkrete Ausgabe und Verlinkung. Eine umfangreiche Spezialoptimierung ohne nachgewiesenen Engpass lenkt leicht von einfacheren Ursachen ab.
Reicht ein SEO-Plugin für die Prüfung?
Ein Plugin unterstützt dich beim Setzen wichtiger Felder. Ob die Website diese Einstellungen korrekt ausliefert und ob Suchmaschinen eine Seite aufnehmen, zeigt es damit noch nicht vollständig. Verbinde die Backend-Einstellungen deshalb mit einer öffentlichen Kontrolle und den verfügbaren Suchdaten.
Quellenstand: 16. September 2026. Die verlinkten Quellen wurden für diese Überarbeitung fachlich geprüft.